Propagation DNS : combien de temps et comment la suivre
« Il faut compter 24 à 72 heures. » C’est la réponse que donnent la plupart des hébergeurs…
Méthode complète pour diagnostiquer une coupure réseau en entreprise, améliorer la connectivité et accélérer le dépannage informatique.
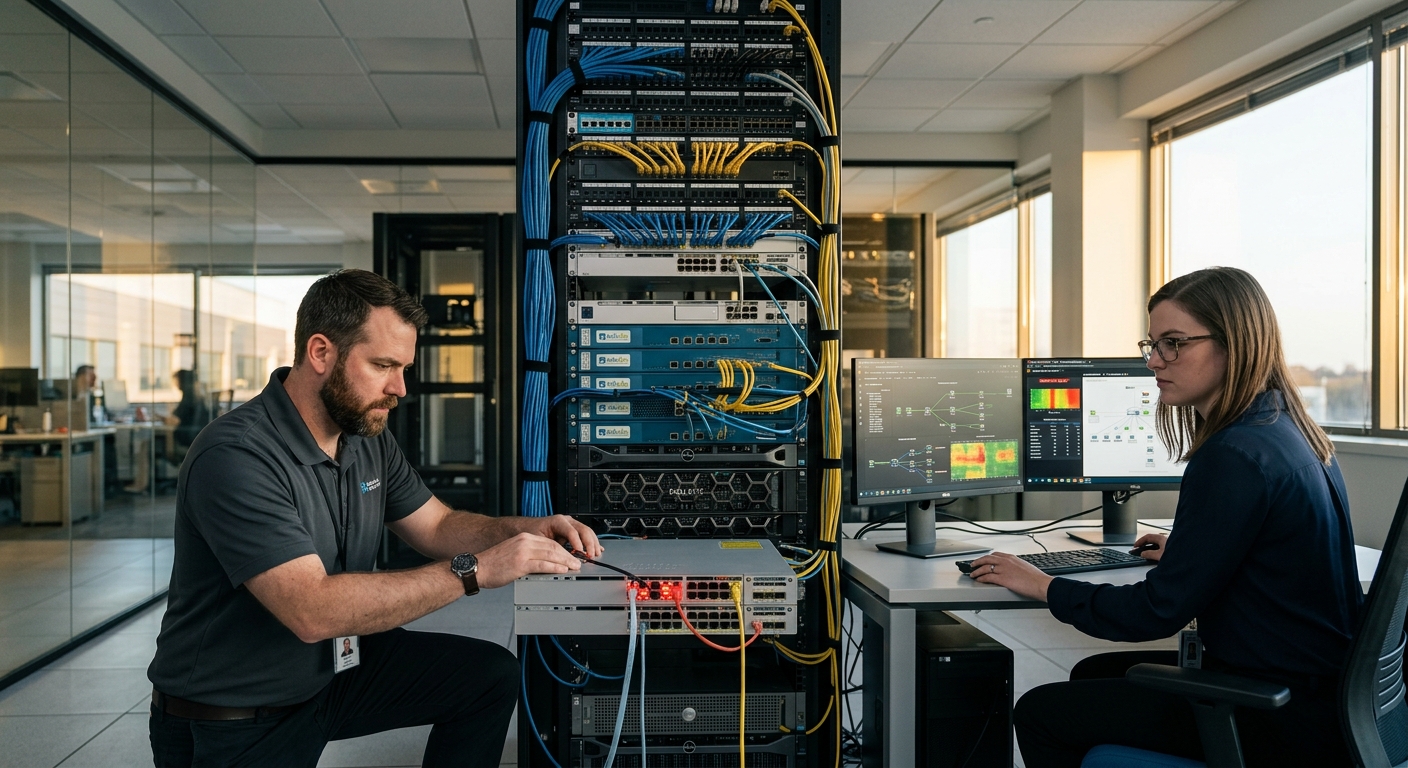
Une panne réseau se paie en minutes, et les minutes se perdent presque toujours au même endroit : avant de savoir qu’il y a une panne. Le monitoring des pannes réseau sert exactement à cela, réduire le délai entre l’incident et sa détection. Voici les quatre sources de données qui le composent, la méthode de diagnostic à dérouler ensuite, et l’angle mort que presque toutes les installations conservent sans le savoir.
Toute amélioration commence par distinguer deux temps que l’on confond en parlant de « temps de panne ».
Dans la plupart des entreprises sans supervision, le premier délai est simplement le temps qu’il faut à un utilisateur pour se plaindre. C’est souvent plusieurs dizaines de minutes, et c’est du temps entièrement récupérable.
| Source | Ce qu’elle apporte | Ce qu’elle ne voit pas |
|---|---|---|
| Tests de disponibilité | L’équipement répond ou ne répond pas | Une lenteur, une saturation, un service dégradé |
| Interrogation SNMP | Charge des interfaces, erreurs, état des ports | Le contenu du trafic |
| Journaux centralisés | Les événements datés : redémarrages, coupures de lien, rejets | Ce que l’équipement ne journalise pas |
| Analyse de flux | Qui parle à qui, en quel volume | L’état matériel des équipements |
Une supervision qui ne fait que le premier test est un interrupteur : elle dit « allumé » ou « éteint ». C’est utile et très insuffisant, car la majorité des incidents réels sont des dégradations et non des ruptures franches.
Attention à l’intervalle d’interrogation, qui est le réglage le plus déterminant et le plus négligé : un contrôle toutes les cinq minutes ne verra jamais une coupure de deux minutes. Vous ne détectez que ce qui dure plus longtemps que votre pas de mesure.
C’est le défaut le plus répandu, et il annule tout le dispositif au moment précis où l’on en a besoin.
Si votre serveur de supervision est installé sur le réseau qu’il surveille, et qu’il envoie ses alertes par ce même réseau, alors une coupure générale l’empêche de vous prévenir. Vous avez un système qui détecte tout, sauf la panne la plus grave.
Quand l’alerte tombe, la méthode consiste à remonter les couches une par une. Chaque étape élimine définitivement une famille de causes, ce qui évite de tourner en rond.
Les mécanismes sous-jacents, attribution d’adresse, résolution de noms et traduction d’adresses, sont expliqués dans notre article sur les bases du fonctionnement d’un réseau. Les connaître transforme ce diagnostic en une lecture, au lieu d’une suite d’essais.
Certaines causes produisent des symptômes qui orientent dans la mauvaise direction. Ces deux-là reviennent constamment.
Quand les deux extrémités d’un lien ne s’accordent pas sur le mode de transmission, le lien fonctionne : les voyants sont verts, les tests simples passent. Mais dès que le trafic augmente, les erreurs explosent et le débit s’effondre.
Le symptôme caractéristique est donc contre-intuitif : tout marche quand personne ne travaille, et rien ne marche aux heures de pointe. Le compteur d’erreurs de l’interface le révèle immédiatement, alors qu’aucun test de disponibilité ne le verra jamais.
Un câble rebranché sur deux ports du même commutateur crée une boucle. Les trames diffusées tournent indéfiniment et saturent le segment en quelques secondes.
Le symptôme est brutal et généralisé : tout un étage tombe d’un coup, les voyants clignotent en continu, et les équipements deviennent injoignables y compris pour l’administration. Le réflexe utile est de chercher ce qui a été branché dans l’heure, pas de redémarrer les serveurs.
Quand la panne vient manifestement du lien, l’appel au support se prépare. Sans éléments factuels, le premier niveau vous fera refaire pendant vingt minutes ce que vous venez de faire.
La réserve est importante, car l’outil est souvent acheté comme une solution alors qu’il n’est qu’un capteur.
Enfin, documentez chaque incident : heure de début, périmètre, tests faits, cause trouvée. Cette trace est ce qui transforme la troisième occurrence d’une panne en résolution de cinq minutes, et c’est le seul moyen d’identifier un équipement qui vieillit mal.
Un dispositif qui interroge en continu les équipements et les services pour détecter une rupture ou une dégradation avant que les utilisateurs ne la signalent. Il combine tests de disponibilité, interrogation des équipements, journaux centralisés et analyse des flux.
Un intervalle plus court que la durée d’incident que vous voulez détecter. Un contrôle toutes les cinq minutes ne verra jamais une coupure de deux minutes : vous ne détectez que ce qui dure plus longtemps que votre pas de mesure.
Le plus souvent parce qu’elle est hébergée sur le réseau qu’elle surveille et qu’elle envoie ses alertes par ce même réseau. Il faut une sonde externe et un canal d’alerte indépendant du lien principal.
C’est le symptôme typique d’un désaccord de duplex sur un lien : il fonctionne à faible charge et s’effondre dès que le trafic augmente. Le compteur d’erreurs de l’interface le confirme, aucun test de disponibilité ne le détecte.
Par chercher ce qui a été branché dans l’heure. Une boucle créée par un câble rebranché sur deux ports du même commutateur sature un segment en quelques secondes et rend les équipements injoignables.
« Il faut compter 24 à 72 heures. » C’est la réponse que donnent la plupart des hébergeurs…
Un ping élevé ne se corrige pas au hasard. Avant de changer d’abonnement ou d’acheter un routeur, il…
Votre téléviseur affiche « Association avec le serveur Freebox en cours » et ne va pas plus loin.…